
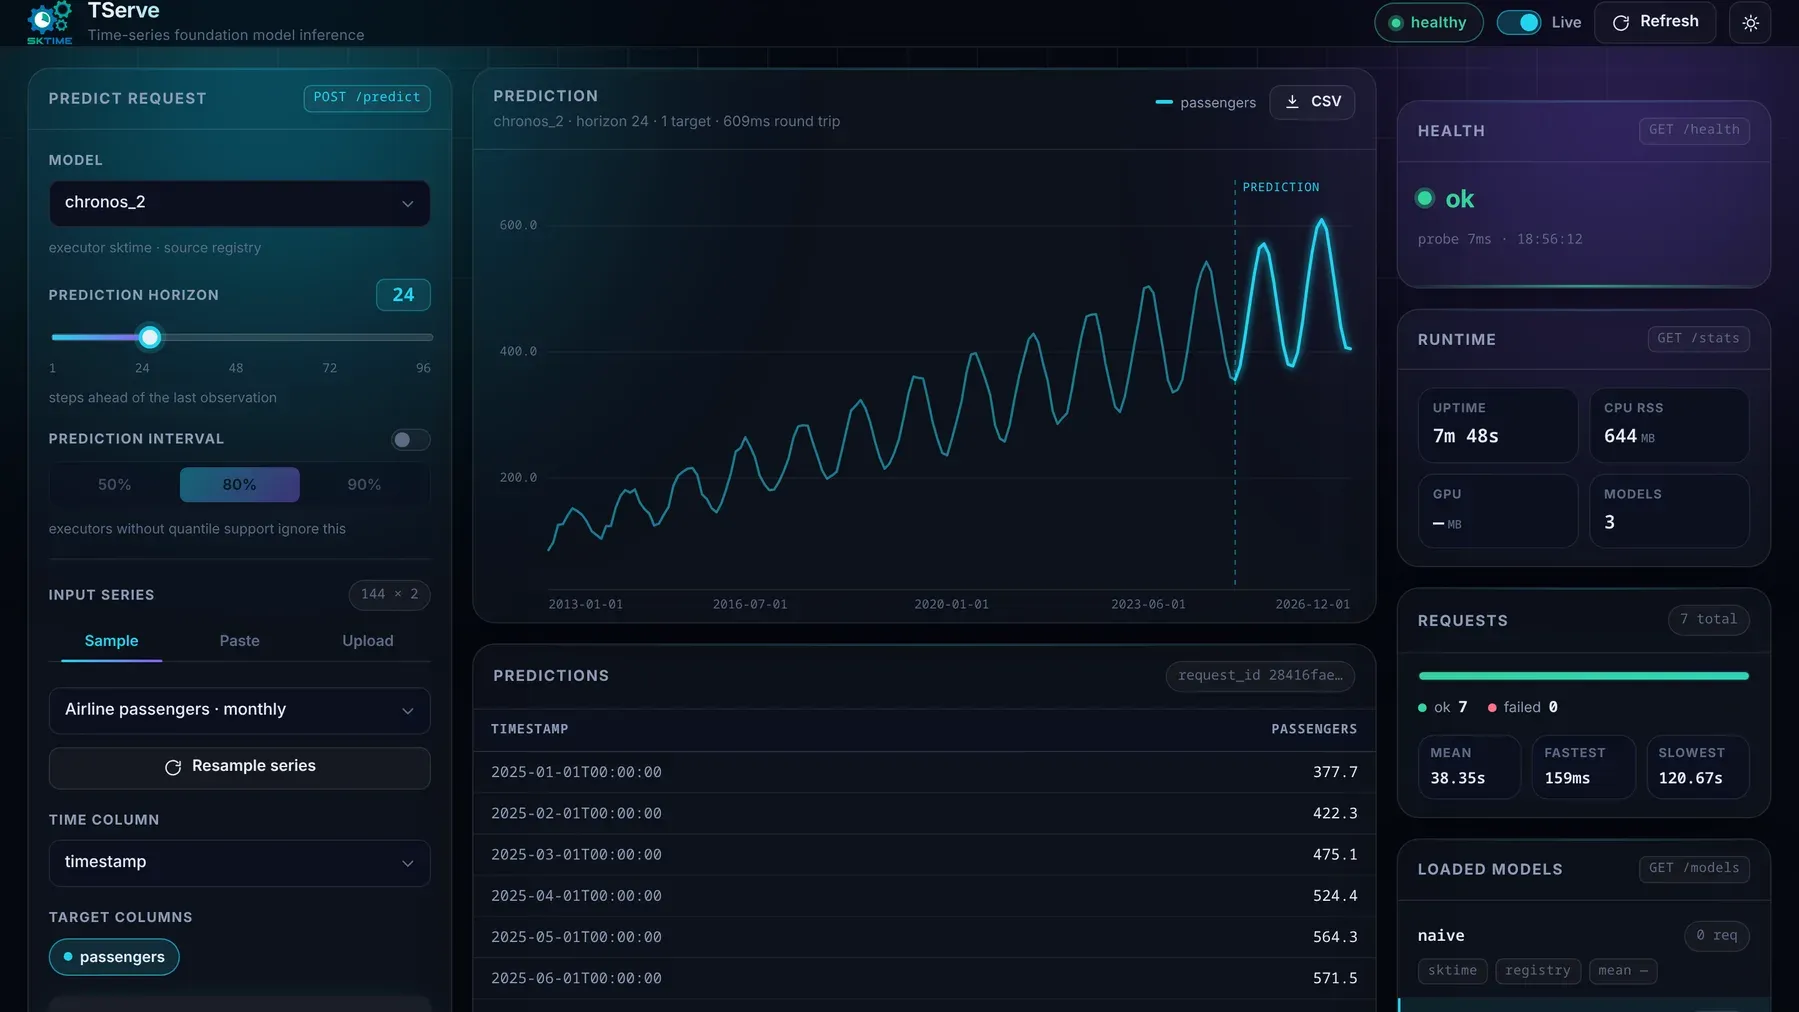
Stellen Sie sich vor, Sie haben ein schönes Forecasting-Modell gebaut. Vielleicht ist es Chronos-2 ohne jede Anpassung, vielleicht eine sktime-Pipeline, an der Sie wochenlang gefeilt haben. Jetzt will ein anderes Team Prognosen daraus haben, und dessen Service ist in Go geschrieben. Oder es ist ein Dashboard. Oder ein ERP-System, das HTTP-Anfragen schicken kann und sonst nichts.
Wie geben Sie diesen Teams eine Prognose, ohne ihnen Ihr Notebook in die Hand zu drücken?
Die erste Idee ist natürlich, einen kleinen Server zu schreiben. predict in
einen FastAPI-Endpunkt packen, an einem Nachmittag erledigt. Oder? Nicht so
schnell.
Sie müssen das Modell einmal beim Start laden und im Speicher halten, denn Chronos-2 bei jeder Anfrage neu zu laden, dauert. Sie müssen ein Anfrage- und ein Antwortformat festlegen, die Tabelle, die der Client schickt, in etwas umwandeln, das Ihr Modell akzeptiert, und die Prognose wieder in die Form bringen, die der Client erwartet. Dann will jemand ein zweites Modell. Mit sktime ist der Aufruf eine Zeile, aber jetzt teilen sich zwei Modelle einen Prozess, die Anfrage muss sagen, welches gemeint ist, und die Abhängigkeiten beider Modelle müssen in dieselbe Umgebung passen. Am Ende landet das alles in einem Docker-Image, das ab jetzt Sie pflegen.
Nichts davon ist schwer. Es ist aber Klempnerarbeit, die mit Forecasting nichts zu tun hat, und jedes Team, das ein Forecasting-Modell bereitstellt, schreibt sie von vorn.
TServe erledigt diese Arbeit einmal. sktime gibt Modellen wie Chronos-2,
TimesFM, Moirai, TTM und TiRex bereits eine gemeinsame Schnittstelle. TServe
setzt das Serving obendrauf: Es lädt die Modelle einmal, hält sie warm und
beantwortet Prognoseanfragen über HTTP. Im Folgenden gehen wir den Weg vom
ersten curl-Aufruf bis zu Ihren eigenen Modellen.

Ihre erste Prognose
TServe gibt es als Docker-Images, eines pro Modellfamilie. Der kurze Weg kommt
also ganz ohne lokales Python aus. Das Image chronos enthält Chronos-2 und
zusätzlich die Hugging-Face-Familien TimesFM 2.x, Chronos Bolt und TTM:
docker run --rm -p 8000:8000 sktime/tserve:chronos chronos_2 timesfm_2_5Dasselbe mit pip, falls Ihnen das lieber ist (Python 3.12 oder neuer):
pip install "tserve[server,chronos]"
tserve chronos_2 timesfm_2_5
Beim ersten Start werden die Gewichte der genannten Modelle heruntergeladen. Danach lädt der Server jedes Modell, rechnet eine Warmup-Prognose und öffnet erst dann den Port. Auf einer Laptop-CPU endet das Log so:
INFO:     [1/3] naive via sktime ........................ ready in 21.98s
INFO:     [2/3] chronos_2 via sktime .................... ready in 12.56s
INFO:     [3/3] timesfm_2_5 via sktime .................. ready in 57.05s
INFO:     3 models ready in 108.05s · CPU 516 MB

INFO:     Starting TServe
INFO:       Dashboard   http://0.0.0.0:8000/
INFO:       Swagger UI  http://0.0.0.0:8000/docs
INFO:       ReDoc       http://0.0.0.0:8000/redoc
naive wird immer geladen, damit Sie einen Server testen können, bevor Sie
irgendetwas herunterladen. Jetzt fünf Tage Umsatz, und wir wollen die nächsten
drei:
curl -s http://127.0.0.1:8000/predict -H "Content-Type: application/json" -d '{
  "past": {
    "timestamp": ["2024-01-01", "2024-01-02", "2024-01-03", "2024-01-04", "2024-01-05"],
    "sales": [120, 135, 128, 142, 138]
  },
  "fh": 3,
  "model": "chronos_2"
}'
{
"predictions": {
"timestamp": ["2024-01-06T00:00:00", "2024-01-07T00:00:00", "2024-01-08T00:00:00"],
"sales": [138.85, 137.86, 137.94]
},
"model": "chronos_2",
"request_id": "d5cc9f50-d084-48e8-8c9f-78497c02e394",
"quantiles": null
}Das war’s schon. past ist eine Tabelle mit einer Zeile pro Zeitstempel, fh
die Anzahl der Schritte in die Zukunft, und model wählt eines der geladenen
Modelle aus.
Zwei weitere Felder sind optional: time nennt die Zeitspalte, target die
Spalten, die prognostiziert werden sollen, zum Beispiel
"time": "timestamp", "target": ["sales"]. Die Anfrage oben lässt beide weg.
Dann nimmt TServe die erste Spalte als Zeit und prognostiziert alle anderen,
hier also nur sales.
Da das schlichtes JSON ist, kann der Aufrufer in jeder Sprache geschrieben sein, die eine POST-Anfrage verschicken kann.
Der Python-Client
Für Python gibt es einen Client (pip install "tserve[client]"). Er nimmt ein
Dict oder eine pandas-, polars- oder pyarrow-Tabelle entgegen und gibt die
Prognose im selben Typ zurück, den Sie geschickt haben. Für ein anderes
Modell ändern Sie ein einziges Argument:
import polars as pl
from tserve.client import Client

past = pl.DataFrame(
    {
        "timestamp": ["2024-01-01", "2024-01-02", "2024-01-03", "2024-01-04", "2024-01-05"],
        "sales": [120, 135, 128, 142, 138],
    }
)

with Client("http://127.0.0.1:8000", timeout=300) as client:
    for model in ["chronos_2", "timesfm_2_5"]:
        result = client.predict(past=past, fh=3, model=model)
        print(model, type(result.predictions))
        print(result.predictions)
chronos_2 <class 'polars.dataframe.frame.DataFrame'>
shape: (3, 2)
┌─────────────────────┬────────────┐
│ timestamp ┆ sales │
│ --- ┆ --- │
│ datetime[ns] ┆ f32 │
╞═════════════════════╪════════════╡
│ 2024-01-06 00:00:00 ┆ 138.846771 │
│ 2024-01-07 00:00:00 ┆ 137.863358 │
│ 2024-01-08 00:00:00 ┆ 137.936951 │
└─────────────────────┴────────────┘
timesfm_2_5 <class 'polars.dataframe.frame.DataFrame'>
shape: (3, 2)
┌─────────────────────┬────────────┐
│ timestamp ┆ sales │
│ --- ┆ --- │
│ datetime[ns] ┆ f32 │
╞═════════════════════╪════════════╡
│ 2024-01-06 00:00:00 ┆ 135.892548 │
│ 2024-01-07 00:00:00 ┆ 136.191101 │
│ 2024-01-08 00:00:00 ┆ 136.596146 │
└─────────────────────┴────────────┘Sieht gut aus! Polars rein, polars raus, und hinter demselben Aufruf stecken zwei
Foundation Models von zwei verschiedenen Anbietern. Intern wandelt der Client
Ihre Tabelle in einen narwhals-Frame
um. Deshalb ist es ihm egal, ob Sie pandas, polars oder pyarrow übergeben. Die
Anfrage prüft er auch gleich selbst: Fehlt die Zeit- oder Zielspalte oder ist
fh nicht positiv, scheitert der Aufruf schon bei Ihnen, bevor irgendetwas
verschickt wird. Ob das Modell geladen ist, prüft der Server.
Warum der lange Timeout
Das Beispiel setzt timeout=300, weil es auf einer Laptop-CPU lief.
Dort antwortete Chronos-2 in deutlich unter einer Sekunde, TimesFM 2.5 brauchte
pro Anfrage aber zwischen 40 und 100 Sekunden. Das ist mehr als die 60 Sekunden,
die der Client standardmäßig wartet. Für alles Ernsthafte empfiehlt sich ein
GPU-Image, siehe unten.
117 Checkpoints, ein Anfrageformat
Der Katalog umfasst 117 Checkpoints, die Sie per Namen laden können. Jede Familie gibt es als pip-Extra und als gleichnamigen Docker-Tag:
| Extra / Tag | Familien | Beispiel |
|---|---|---|
hub | Chronos Bolt, Chronos T5, TTM, TimesFM 2.x | chronos_bolt |
chronos | Chronos-2 | chronos_2 |
moirai | Moirai 2, Moirai 1.x, Lag-Llama | moirai_2 |
timesfm3 | TimesFM 3 | timesfm_3 |
tirex | TiRex | tirex |
tirex2 | TiRex-2 | tirex_2 |
toto | Toto-2 | toto_2_0_4m |
granite | FlowState | flowstate |
kronos | Kronos, WindFM | kronos |
mantis | Mantis | mantis_8m |
t0 | T0 | t0 |
tafsut | Tafsut | tafsut |
full | alle oben genannten |
Zu jedem Tag gibt es außerdem eine GPU-Variante mit dem Suffix -gpu, zum
Beispiel sktime/tserve:hub-gpu zusammen mit --gpus all. Die vollständige
Liste mit allen Checkpoint-Namen steht im
Modellkatalog.
Was die Familien können, ist unterschiedlich. Manche prognostizieren mehrere Reihen gemeinsam, manche nutzen Kovariaten, manche liefern Quantile. TServe rät dabei nicht: Es liest diese Fähigkeiten aus dem sktime-Estimator selbst aus, und die Fähigkeitstabelle listet sie pro Familie auf. Zwei Beispiele.
Kovariaten
Angenommen, Sie wissen im Voraus, wann Sie eine Werbeaktion fahren. Eine Kovariate
steht sowohl in past als auch in future, und future deckt den
Prognosehorizont ab. Simulieren wir 80 Monate Umsatz, in denen in zufälligen
Monaten Aktionen laufen, die den Umsatz um etwa 40 erhöhen. Anschließend planen
wir eine Aktion für November:
import numpy as np
import pandas as pd

rng = np.random.default_rng(1)
promo = (rng.random(80) < 0.25).astype(int)  # Aktionen in zufälligen Monaten
past = pd.DataFrame(
    {
        "month": pd.date_range("2019-01-01", periods=80, freq="MS"),
        "sales": (100 + 40 * promo + rng.normal(0, 2, 80)).round(1),
        "promo": promo,
    }
)
future = pd.DataFrame(
    {
        "month": pd.date_range("2025-09-01", periods=4, freq="MS"),
        "promo": [0, 0, 1, 0],  # Aktion im November geplant
    }
)

with Client("http://127.0.0.1:8000") as client:
    result = client.predict(
        past=past, future=future, time="month", target=["sales"], fh=4, model="chronos_2"
    )

print(result.predictions)
month sales
0 2025-09-01 98.784592
1 2025-10-01 98.926384
2 2025-11-01 143.221909
3 2025-12-01 98.570877past enthält den Verlauf von sales und promo. future deckt die vier Prognosemonate ab und enthält nur promo, denn das ist der Teil, den Sie bereits kennen. Das Modell ergänzt sales für diese Monate (die gestrichelten Balken), samt Sprung im November. Die Werte stammen aus den simulierten Daten und der Chronos-2-Prognose aus dem Code oben.Schön! Chronos-2 setzt den Sprung von etwa 40 genau in den November, also in den
Monat, für den future die Aktion vorsieht. Verschieben Sie die 1 in future
in einen anderen Monat, wandert der Sprung mit.
Für Werte, die sich über die Zeit nicht ändern, etwa den Filialtyp, gibt es
außerdem das Feld static mit genau einer Zeile.
Prognoseintervalle
Zum Planen reicht eine Punktprognose allein oft nicht. Geben Sie quantiles an,
liefern Modelle, die das unterstützen, das Intervall neben der Punktprognose.
Hier TimesFM 2.5 auf zwei Jahren simulierter Monatsumsätze mit Trend und
jährlicher Saison:
import numpy as np

rng = np.random.default_rng(0)
t = np.arange(24)
monthly = pd.DataFrame(
    {
        "month": pd.date_range("2023-01-01", periods=24, freq="MS"),
        "sales": (200 + 3 * t + 25 * np.sin(2 * np.pi * t / 12) + rng.normal(0, 5, 24)).round(1),
    }
)

with Client("http://127.0.0.1:8000", timeout=300) as client:
    result = client.predict(past=monthly, fh=3, model="timesfm_2_5", quantiles=[0.1, 0.9])

print(result.predictions)
print(result.quantiles)
month sales
0 2025-01-01 255.137131
1 2025-02-01 260.312500
2 2025-03-01 265.058380
month sales_0.1 sales_0.9
0 2025-01-01 253.657379 265.641541
1 2025-02-01 259.207428 273.117676
2 2025-03-01 265.114136 279.472137predictions bleibt die Punktprognose, quantiles enthält das 10-%- und das
90-%-Quantil. Zusammen ergeben sie ein 80-%-Prognoseintervall: Laut Modell liegt
der Umsatz im Januar 2025 mit einer Wahrscheinlichkeit von 80 % zwischen 253,7
und 265,6, mit 10 % darunter und mit 10 % darüber. Wie weit Sie diesen 80 %
trauen können, hängt natürlich davon ab, wie gut das Modell auf Ihren Daten
kalibriert ist.
Eigene sktime-Modelle mitbringen
Foundation Models sind nur die halbe Geschichte. Oft wollen Sie ein Modell bereitstellen, das Sie selbst gebaut haben: einen konfigurierten Estimator, einen Checkpoint, den der Katalog nicht kennt, oder eine Pipeline aus sktime-Bausteinen. TServe stellt jeden sktime-Forecaster bereit, und Sie können ihn auf drei Wegen übergeben.
TServe fittet bei jeder Anfrage
TServe ruft fit auf der past-Tabelle
auf, die Sie schicken, und danach predict. Was Sie übergeben, ist
also die Konfiguration des Modells. Haben Sie es vor dem Speichern
gefittet,
wird dieser Zustand ersetzt. Für die Foundation Models im Katalog, die alle
zero-shot laufen, ist das genau richtig: past ist ihr Kontext. Ein
klassisches Modell lernt aus genau den Zeilen in der Anfrage.
Der erste Weg ist eine Craft-Spec. Mit der Funktion
sktime.registry.craft
baut sktime einen Estimator aus einem einfachen String, der wie Python-Code
aussieht, zum Beispiel 'NaiveForecaster(strategy="drift")'. Der String ist ein
Klassenaufruf mit Argumenten, Imports brauchen Sie keine. Auf der Kommandozeile
schreiben Sie ihn als id=spec direkt neben die Katalognamen:
docker run --rm -p 8000:8000 sktime/tserve:chronos chronos_2 \
  'ttm_local=TinyTimeMixerForecaster(model_path="ibm-granite/granite-timeseries-ttm-r3", revision="52-16-dec-52-r3", fit_strategy="zero-shot")' \
  'drift=NaiveForecaster(strategy="drift")'
GET /models listet dann alle auf, und das Feld source verrät, woher jedes
Modell stammt:
{
  "models": [
    {"id": "naive", "executor": "sktime", "source": "registry"},
    {"id": "chronos_2", "executor": "sktime", "source": "registry"},
    {"id": "ttm_local", "executor": "sktime", "source": "craft"},
    {"id": "drift", "executor": "sktime", "source": "craft"}
  ]
}
Eine Anfrage mit "model": "ttm_local" geht an Ihre TTM-Konfiguration, so wie
chronos_2 an Chronos-2 geht. Die Spec wird nur einmal ausgewertet, beim Start
in Ihrem Prozess. Über das Feld model einer HTTP-Anfrage kann sie niemals
hereinkommen.
Der zweite Weg ist ein gespeichertes Modell. Rufen Sie save() auf einem
beliebigen sktime-Forecaster auf, legen Sie die .zip-Dateien in ein Verzeichnis
und verweisen Sie TServe darauf:
from pathlib import Path
from sktime.forecasting.chronos import ChronosForecaster

Path("my-models").mkdir(exist_ok=True)
model = ChronosForecaster(model_path="amazon/chronos-bolt-tiny")
model.save("my-models/custom-model-1")  # schreibt my-models/custom-model-1.zip
tserve --models-dir my-models custom-model-1 chronos_boltTServe lädt nur die Dateien, die Sie auf der Kommandozeile nennen, nie das ganze Verzeichnis. In Docker mounten Sie das Verzeichnis und übergeben den Pfad im Container.
Der dritte Weg führt über Python. Sie übergeben Paare (id, estimator) aus
Objekten, die bereits im Speicher liegen:
from sktime.forecasting.chronos import ChronosForecaster
from tserve.server import Server

bolt = ChronosForecaster(model_path="amazon/chronos-bolt-mini", config={"device_map": "auto"})

Server(model=["chronos_bolt", ("bolt-mini-local", bolt)], host="127.0.0.1", port=8000).run()
Auf diese Weise betten Sie TServe auch in Ihre eigene Python-Anwendung ein. Katalogmodelle, Craft-Specs, gespeicherte Zips und Live-Objekte lassen sich in einer Liste beliebig mischen.
Die Abhängigkeiten Ihres Modells
TServe installiert nur die Pakete, die seine Extras
deklarieren. Braucht Ihr eigenes Modell mehr, installieren Sie das vorher.
ThetaForecaster zum Beispiel braucht statsmodels, und
das deklariert keines der TServe-Extras. Bauen Sie also entweder ein eigenes
Image auf Basis des TServe-Images, oder installieren Sie TServe in eine Umgebung,
die schon alles mitbringt, was Ihr Modell braucht.
Das Dashboard
Sobald der Server läuft, öffnen Sie http://127.0.0.1:8000/ im Browser. Das
Dashboard zeigt, ob der Server gesund ist, wie viele Anfragen jedes Modell
beantwortet hat und wie schnell. Sie wählen ein geladenes Modell, legen einen
Horizont und optional ein Prognoseintervall fest und prognostizieren eine der
eingebauten Beispielreihen. Oder eine beliebige CSV, die Sie einfügen oder per
Drag-and-drop ablegen. Die CSV wird in Ihrem Browser geparst, und das Ergebnis
können Sie wieder als CSV herunterladen.
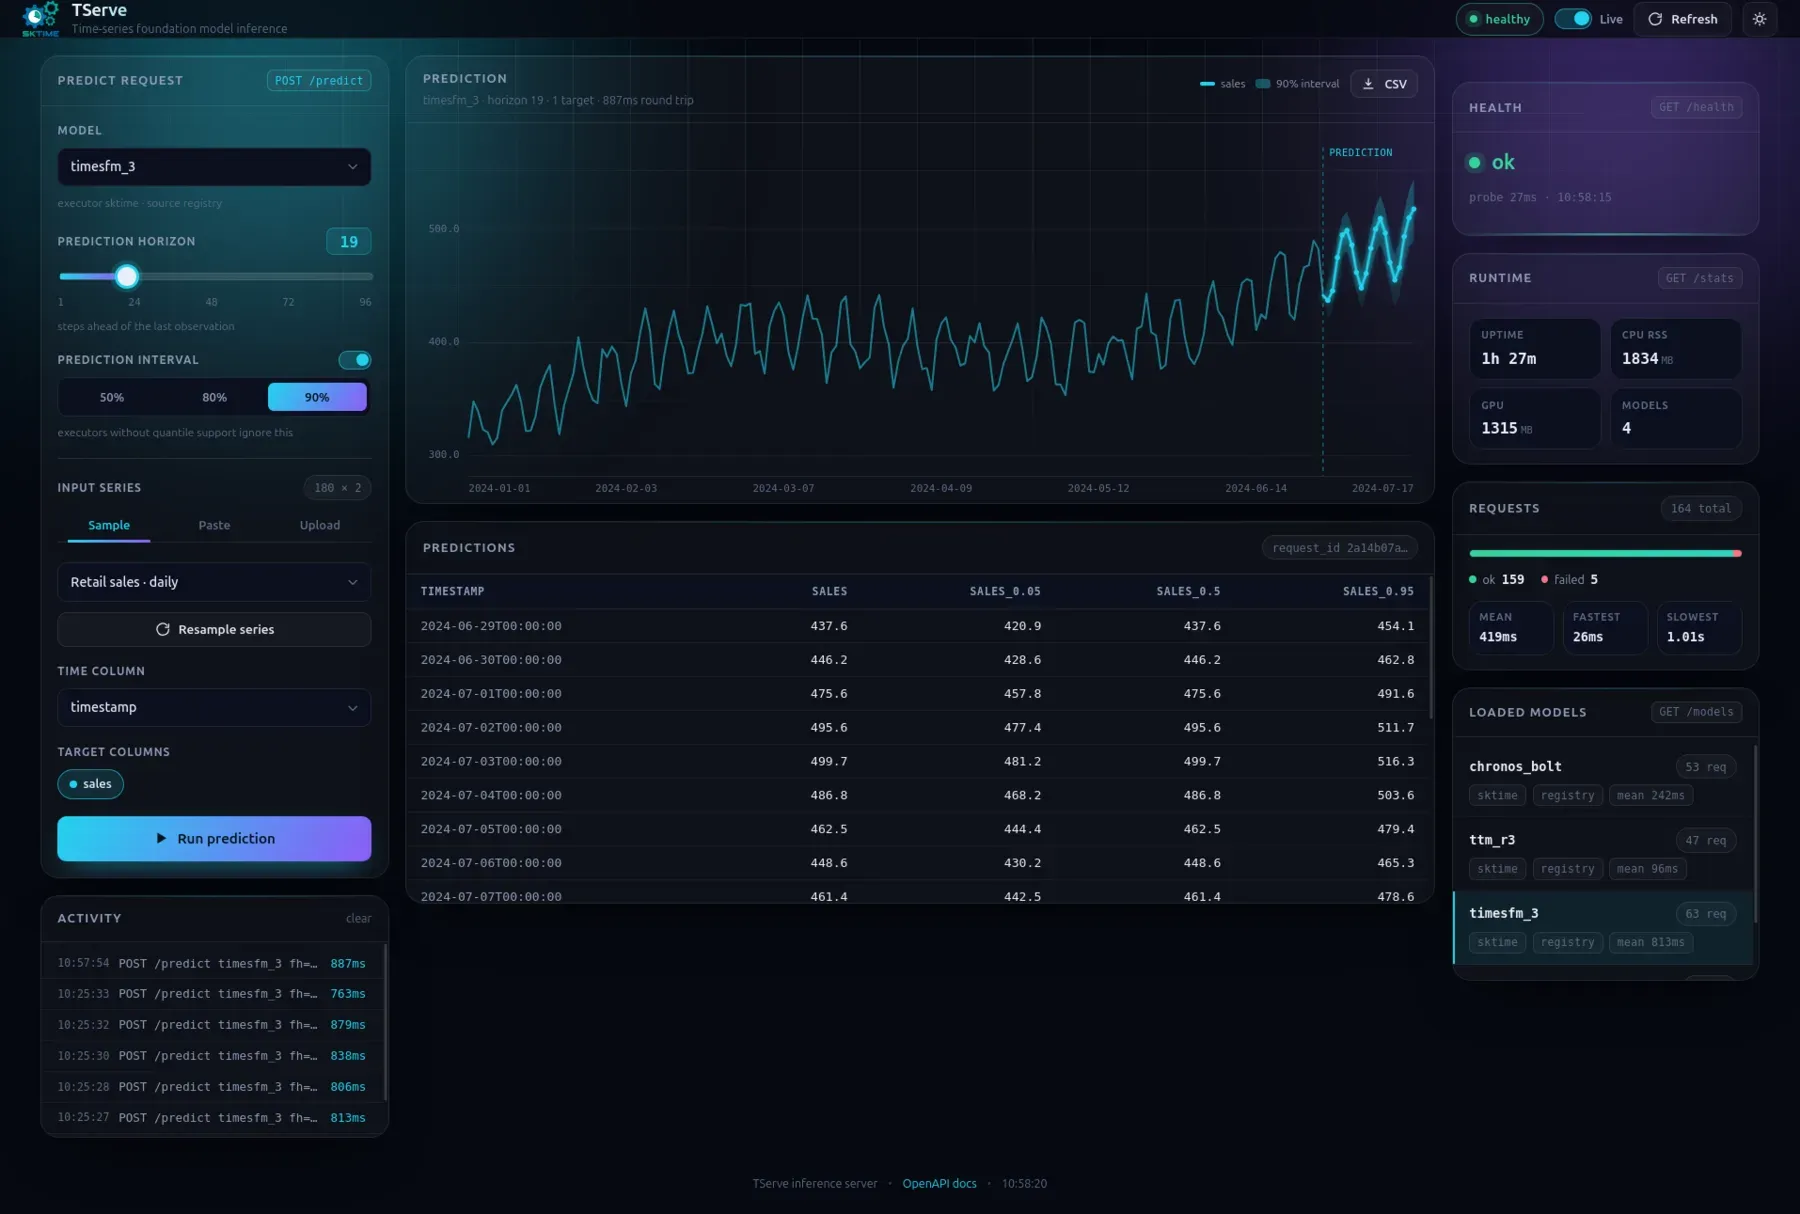
Für Kolleginnen und Kollegen, die keinen Code schreiben, ist das der schnellste Weg, ein Modell auf den eigenen Daten auszuprobieren. Ihnen zeigt es schnell, ob ein frisch deployter Server funktioniert. Brauchen Sie die Zahlen maschinenlesbar, liefern drei Endpunkte dieselben Werte:
| Route | Rückgabe |
|---|---|
GET /health | ob der Prozess läuft |
GET /models | die Modelle, die dieser Prozess geladen hat (nicht der ganze Katalog) |
GET /stats | Laufzeit, Speicher sowie Anfragen und Latenz pro Modell |
Swagger UI unter /docs und ReDoc unter /redoc dokumentieren die komplette
HTTP-API, generiert aus dem laufenden Server. Geht eine Anfrage schief, bekommen
Sie einen Statuscode, der den Grund nennt: 422 für einen Body, der nicht zum
Schema passt, 400 für ein nicht geladenes Modell oder eine fehlende Spalte,
jeweils mit request_id und einer Meldung. Fragen Sie aus Python nach einem
Modell, das der Server nicht hat, sieht das so aus:
RuntimeError model 'moirai_2' is not loaded on this server (loaded: 'chronos_2', 'naive', 'timesfm_2_5')Warum selbst betreiben?
TServe läuft auf Ihrer eigenen Hardware, per pip, aus einem Docker-Image oder innerhalb Ihrer eigenen Python-Anwendung. Eine gehostete TServe-API gibt es nicht. Das hat zwei Folgen.
Ihre Daten verlassen nie Ihren Rechner. Und niemand kann den Preis
erhöhen oder das Modell abschalten, auf das Sie angewiesen sind. Viele
Forecasting-Foundation-Models werden als zugangsbeschränkte Cloud-Dienste
verkauft, selbst wenn ihre Gewichte offen und unter permissiven Lizenzen
verfügbar sind. Franz hat darüber in
Der KI-ser ist nackt geschrieben. TServe ist
die Serverseite desselben Arguments: Diese Modelle selbst zu betreiben, kostet
Sie ein einziges docker run.
Der Server selbst ist Open Source unter der BSD-3-Clause-Lizenz. Achtung: Diese Lizenz gilt für TServe, nicht für die Modelle. Jeder Checkpoint hat eine eigene Lizenz seines Anbieters. Prüfen Sie sie also, bevor Sie ein Modell in Produktion bringen.
Was TServe (noch) nicht kann
TServe steht bei Version 0.1.0, veröffentlicht am 24. September 2026. Bevor Sie darauf aufbauen, sollten Sie ein paar Dinge wissen:
- Keine Authentifizierung. Jede Route steht allen offen, die den Port erreichen. Stellen Sie den Server also hinter Ihren eigenen Reverse Proxy oder in ein privates Netzwerk.
- Eine Reihe pro Anfrage.
pastdarf mehrere Zielspalten haben, Panel- und hierarchische Daten deckt das Anfrageformat vorerst aber nicht ab. - Noch keine stabile API. Bis 1.0 kann jedes Minor-Release die HTTP-API, den Python-Client oder die Kommandozeile ändern.
Ausprobieren
TServe wurde von Armaghan Shakir entwickelt, der fast den gesamten Code selbst geschrieben hat. Danke!
pip install "tserve[server,chronos]"
tserve chronos_2- Code: github.com/sktime/tserve
- Dokumentation: tserve.readthedocs.io
- Modellkatalog: 117 Checkpoints
- Docker-Images: hub.docker.com/r/sktime/tserve
Wenn etwas nicht funktioniert oder Ihnen ein Modell fehlt, eröffnen Sie bitte ein Issue. Und wenn Sie TServe mit Support im Rücken in Produktion betreiben wollen, hilft Ihnen unser Enterprise-Team weiter.